Implantando no Azure App Service — modo cluster
Do zero a um cluster de duas instâncias, verificado na visão Instâncias do dashboard.
Este é o passo a passo da única topologia com múltiplas instâncias suportada: um Azure Web App executando a imagem de container Linux, com escala horizontal em um único App Service Plan. Os mecanismos se coordenam por meio do banco de dados operacional e do compartilhamento de trabalho e independem do host, mas a topologia suportada é exatamente esta — duas VMs on-premises usando um mesmo SQL Server rodariam o mesmo código, mas não são documentadas, testadas nem suportadas.
Alta disponibilidade e seus limites lista o que esta topologia não oferece — atualizações que exigem parada total, ausência de deployment slots, cotas de limite de requisições (rate limiting) que se multiplicam, coleta de métricas que cai em uma instância arbitrária. É melhor conhecer cada item agora do que descobri-lo numa janela de mudança.
Instalações de instância única ficam em outra página e não são afetadas: systemd no Linux, Windows
Service, Docker e o console em primeiro plano estão em Instalação, e nada nesta
página se aplica a eles. Cluster:Enabled tem padrão false, e, com ele desligado, o produto é,
byte a byte, o de instância única.
Visão geral da topologia
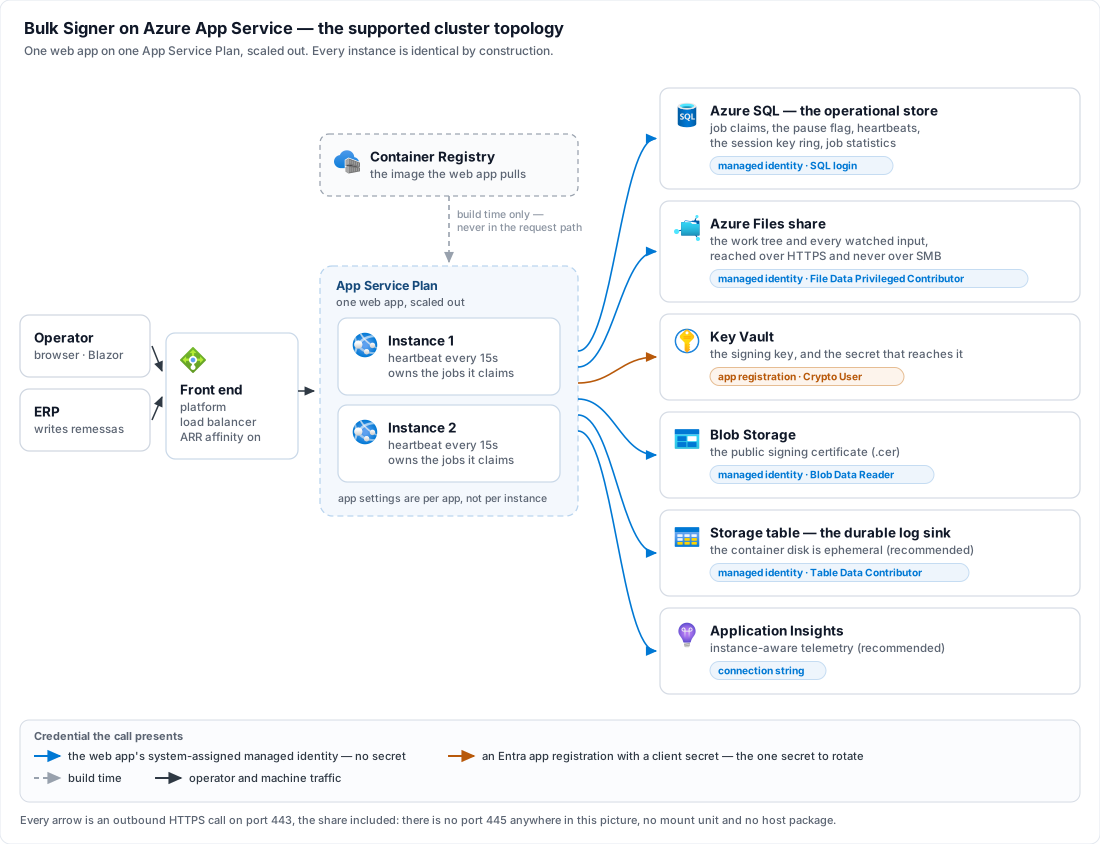
Toda seta é uma chamada HTTPS de saída na porta 443, inclusive a do compartilhamento: este produto alcança o Azure Files pelo SDK de armazenamento e nunca por SMB, então não existe porta 445 em lugar nenhum do diagrama, nem unit de montagem, nem pacote no host.
Leia juntas as duas setas que chegam ao Key Vault, porque elas são a única assimetria da página. Seis permissões pertencem à identidade gerenciada do web app; exatamente uma pertence a um registro de aplicativo do Entra — o direito de assinar com a chave — e é a única credencial aqui que é um segredo que alguém precisa rotacionar. O passo 3 explica de onde isso vem, e por quê.
Antes de começar
Seis coisas precisam estar resolvidas antes do primeiro boot. Se faltar alguma das quatro primeiras, o resultado é uma recusa de boot, um erro fatal ou uma linha de readiness vermelha, e não uma surpresa em tempo de execução; as duas últimas são recomendações que esta topologia torna muito mais fortes do que em outros cenários.
| # | O quê | Por que o modo cluster exige |
|---|---|---|
| 1 | Um banco de dados Azure SQL, mais um login em db_datareader + db_datawriter + db_ddladmin | O banco operacional é o ponto de coordenação do cluster: as reivindicações de job, a flag de pausa, a tabela de heartbeat e o key ring de sessão ficam todos ali. Cluster:Enabled = true com Database:Provider diferente de SqlServer é recusado no boot. Este serviço cria suas tabelas, não seu banco de dados. |
| 2 | Um compartilhamento do Azure Files (SMB) para a árvore de trabalho, com todo diretório de entrada monitorado criado dentro dele | Storage:Provider e cada entrada de Storage:Inputs[] precisam resolver para AzureFiles; caso contrário, o boot é recusado. O lease do banco local é um controle interno ao processo, que não exclui nada fora dele, e uma pasta local de uma instância é invisível para as demais. Um compartilhamento NFS é recusado explicitamente. |
| 3 | Uma decisão entre as duas origens de certificado que não dependem do host — Pfx lido de um blob, ou AzureKeyVault | Pkcs11 e WindowsStore são recusados no boot: um token ou um repositório de máquina fica em uma única máquina, e as instâncias do cluster são intercambiáveis. Sobram duas, e nenhuma é a vencedora óbvia — o passo 3 apresenta a escolha e o que ela custa. Nada precisa existir ainda. |
| 4 | A imagem de container em um registry do qual o web app consiga fazer pull | A Lacuna a publica em seu repositório privado de imagens Docker; o passo 1 copia a tag que você recebeu para um registry seu, o que permite fazer o pull com identidade gerenciada. |
| 5 | Uma tabela do Azure Storage para o destino de logs | Fortemente recomendada, mas não obrigatória. O disco do container é efêmero, então arquivos de log rotacionados são descartados a cada reciclagem; deixar Logging:AzureTable:Enabled = false no modo cluster registra um Critical na inicialização, e o serviço sobe assim mesmo. Nada limpa essa tabela — leia Retenção e agende o script de limpeza antes de ligar o destino. |
| 6 | Um recurso do Application Insights | Também recomendado, mas não obrigatório, por um motivo específico desta topologia: /api/metrics atrás do balanceador de carga alcança uma instância arbitrária, então a coleta pelo Prometheus não tem continuidade aqui. A distro do Application Insights distingue as instâncias nativamente e é o caminho de observabilidade recomendado para o cluster — veja Telemetria. |
Habilite no web app uma identidade gerenciada atribuída pelo sistema antes de qualquer outra coisa,
porque assim quase tudo aqui consegue se autenticar sem segredo: Credential = ManagedIdentity para o
compartilhamento do Azure Files, Authentication=Active Directory Managed Identity na connection string
do SQL, e o mesmo modo para o blob do certificado e para a tabela de logs. Cada uma é uma permissão
separada, ainda que uma única identidade tenha todas — veja Segurança.
Signing:…:Certificate:AzureKeyVault exige AppId e AppSecret; o bloco não tem chave
Credential nem modo de identidade gerenciada; por isso, com essa origem, o direito de assinar
pertence a um registro de aplicativo do Entra com um client secret. Esse é o único segredo que esta
topologia não consegue eliminar por design, e o passo 3 o
compara com o que o cofre oferece. Vale saber disso antes de escolher uma origem de certificado.
Dimensionando o plano e o banco de dados
Dois dos pré-requisitos acima não só precisam existir como também precisam ser dimensionados, e um número que o operador geralmente conhece de antemão dimensiona ambos: assinaturas por dia. A tabela é um ponto de partida, não um resultado de benchmark — o que ela não tem como saber são os seus arquivos, e eles influenciam a resposta mais do que o volume. Uma assinatura CAdES sobre uma remessa CNAB240 e uma assinatura PAdES sobre um PDF digitalizado de 300 páginas são, para este produto, um job cada, mas não chegam nem perto de representar o mesmo trabalho.
| Assinaturas por dia | App Service Plan | Azure SQL — máx. de vCores |
|---|---|---|
| 0 – 1.000 | P0 V3 × 1 | 2 |
| 1.001 – 5.000 | P1 V3 × 1 | 4 |
| 5.001 – 20.000 | P1 V3 × 2 | 6 |
| 20.001 – 100.000 | P2 V3 × 2 | 8 |
| 100.001 – 1.000.000 | P2 V3 × 2 | 8 |
× N é o número de instâncias — --number-of-workers em um plano, nunca um segundo plano.
Qualquer que seja a sua linha, o passo 2 começa com um worker, e é no passo 7
que você escala até o número acima: é no primeiro boot que todas as recusas aparecem, e ler o console
de uma instância é mais fácil do que ler o de duas.
As duas últimas linhas usam o mesmo hardware, e esse é o dado mais informativo da tabela. Por
volta de 100.000 assinaturas por dia, a camada web deixa de ser a restrição. Um job é uma assinatura, e
o que a limita a partir daí é a origem do certificado — um Pfx já em memória, ou uma ida e volta ao
Key Vault — junto com o I/O do compartilhamento. Dez vezes o volume no mesmo plano indica, portanto,
onde o trabalho de fato está, e não uma folga que o plano mantinha de reserva. No topo dessa faixa,
dimensione primeiro
a ida e volta ao cofre e
Pipeline:MaxConcurrency, e aumente o plano por último.
Um SKU maior não assina mais arquivos ao mesmo tempo. Pipeline:MaxConcurrency é a única coisa que
faz isso; o valor é por instância, e o passo 3 o define
como 4 — então uma linha × 2 significa oito assinaturas em andamento, e é com oito, não com os
quatro configurados, que a origem do certificado precisa lidar. Em
Alta disponibilidade, essa mesma multiplicação aparece como limitação, e não
como funcionalidade.
As duas linhas × 1 não precisam desta página. O modo cluster é válido com uma instância — o
passo 6 sobe exatamente assim —, mas, com uma instância, nada do que ele coordena está de fato
trabalhando, e uma implantação que permanece assim está pagando por um banco Azure SQL e um
compartilhamento do Azure Files de que não precisaria. Abaixo de 5.000 assinaturas por dia,
leia Instalação primeiro e volte quando o motivo for o volume, ou uma segunda
instância, e não a plataforma.
Um número de vCores máximo descreve a camada de computação serverless do Azure SQL, onde esse
número é o teto até o qual o banco pode escalar (--max-capacity); na camada provisionada, leia o mesmo
número como a quantidade de vCores, já que não há o que escalar. Em nenhum dos casos conte com a
economia do auto-pause no orçamento. Este produto consulta o banco continuamente, e no modo cluster cada
instância também grava um heartbeat a cada Cluster:HeartbeatSeconds — 15 por padrão —, de modo que o
banco nunca fica ocioso nem perto da hora que o auto-pause exige. Dimensione-o como
um banco de dados que está sempre no ar.
Nada disso é um argumento de vazão a favor do SqlServer. A coluna de vCores dimensiona um banco
cujo provider Antes de começar já tornou obrigatório aqui; não é um motivo para
migrar uma instalação de instância única do SQLite, que também não é o teto deste pipeline — essa
decisão é tratada em
Instalação, com seus próprios critérios.
1. Importe a imagem
A Lacuna publica a imagem de container no seu repositório privado de imagens Docker e fornece a você um usuário e um token de acesso a ele — veja Obtendo o produto. Nenhum build acontece aqui: você copia a tag indicada para instalação para um container registry seu.
az group create --name bulksigner-rg --location brazilsouth
az acr create --name <nome-do-registry> --resource-group bulksigner-rg --sku Basic
az acr import --name <nome-do-registry> \
  --source <registry-da-lacuna>/bulksigner:<versão> \
  --image bulksigner:<versão> \
  --username <usuário-do-registry> --password <token-do-registry>
O az acr import é uma cópia de registry para registry feita pelo próprio serviço: as camadas nunca
passam pela sua estação de trabalho e nenhum daemon Docker local é envolvido. Pule qualquer uma das
linhas create se o resource group ou o registry já existirem — a importação é a parte indispensável, e
o Basic é suficiente para uma imagem baixada por um punhado de instâncias.
Importe uma tag <versão> explícita, e não latest. A tag que você indicar aqui é a que o passo 2 fixa
no web app, e nesta topologia uma atualização é uma
janela de parada total — algo que você agenda, e não algo que uma
reciclagem da plataforma impõe a você.
Por que um registry seu, em vez de apontar o web app direto para o da Lacuna. Dois motivos, e o
primeiro orienta o resto desta página: o app faz o pull com a sua identidade gerenciada (AcrPull,
passo 2), e uma identidade do seu tenant só pode receber uma função (role) em um registry do seu tenant
— um registry de terceiros exige um usuário e uma senha nos app settings, o que é mais um segredo a
rotacionar, e justamente o tipo de segredo que esta arquitetura se esforça para eliminar. O segundo é
disponibilidade: o App Service faz o pull da imagem de novo em toda instância que sobe, então a escala
horizontal (passo 7) e as reciclagens da plataforma passariam a depender de que um
registry fora da sua assinatura do Azure respondesse naquele momento.
2. Crie o plano e o app — uma instância primeiro
az appservice plan create --name bulksigner-plan --resource-group bulksigner-rg --is-linux --sku P1V3 --number-of-workers 1
O P1V3 acima é o SKU do exemplo, não uma recomendação —
Dimensionando o plano e o banco de dados indica qual deles
o seu volume exige.
O Basic (B1) é o mínimo, por ser a primeira camada que permite escala horizontal — e ele se limita a três instâncias, o que também limita o que o Health check pode fazer por você, já que desviar o tráfego de uma instância não saudável exige ter para onde desviá-lo. Para produção, a resposta é o Premium v3. Comece deliberadamente com um worker: é no primeiro boot que todas as recusas aparecem, e ler o console de uma instância é mais fácil do que ler o de duas.
az webapp create --name bulksigner --resource-group bulksigner-rg --plan bulksigner-plan --container-image-name <nome-do-registry>.azurecr.io/bulksigner:<versão>
bulksigner:<versão> é o repositório e a tag que o passo 1 importou — no seu
registry, não no da Lacuna. Fixe essa tag em vez de latest, para que uma atualização seja uma ação
sua, e não o efeito colateral de um restart.
az webapp identity assign --name bulksigner --resource-group bulksigner-rg
Conceda a essa identidade AcrPull no registry, Storage File Data Privileged Contributor no
compartilhamento, um login SQL mapeado para ela em db_datareader + db_datawriter + db_ddladmin,
Storage Blob Data Reader no container que guarda o certificado, e Storage Table Data Contributor na
própria tabela de logs — restrita a essa tabela, que é tudo de que o destino precisa. O passo 3 adiciona
a sexta e última permissão.
Com AzureKeyVault, quem acessa a chave do cofre é o registro de aplicativo do Entra indicado em
AppId, nunca esta identidade — então get + sign concedidos aqui iriam para a entidade de
segurança (principal) errada, e o boot falharia mesmo assim, com uma mensagem sobre o cofre que não
explica o motivo. A única permissão que esta identidade recebe nesse cofre é Key Vault Secrets User,
para ler o próprio segredo do registro de aplicativo como app setting.
Depois, configure o app para fazer o pull com essa identidade em vez de uma senha de registry:
az resource update --ids $(az webapp config show --name bulksigner --resource-group bulksigner-rg --query id -o tsv) --set properties.acrUseManagedIdentityCreds=True
Sem essa última linha, o pull recorre a credenciais de registry que o app não tem, e o primeiro sintoma é um container que nunca inicia — sem nada no log da aplicação, porque ainda não há aplicação rodando.
3. A chave de assinatura fica em um cofre
Duas origens passam pelas recusas de boot de Antes de começar, e é neste passo que você escolhe entre elas. Elas são realmente equivalentes — a escolha é de política, não técnica, e cada uma abre mão de algo que a outra preserva.
Pfx lido de um blob | AzureKeyVault | |
|---|---|---|
| Onde está a chave privada | Um .pfx no Blob Storage, carregado na memória da instância no boot | Dentro do cofre, permanentemente. Cada assinatura é uma chamada remota e a chave nunca deixa o Azure |
| Credencial | A identidade gerenciada do web app, Storage Blob Data Reader. Sem segredo | Um registro de aplicativo do Entra com um client secret, mais uma permissão da identidade gerenciada para ler esse segredo |
| Latência de assinatura | Nenhuma além da criptografia local | Uma ida e volta ao cofre por job |
| Se o Azure estiver inalcançável | Já assinou; o pipeline continua assinando | Todo job falha até o cofre responder |
| Auditoria | O histórico de jobs deste produto, e nada mais | Cada assinatura é uma operação registrada no Key Vault — uma contagem independente para conciliar com o histórico de jobs |
Resumindo com franqueza: o AzureKeyVault garante uma chave que não pode ser exfiltrada de uma
instância comprometida, e o preço é o único segredo que esta topologia não teria de outra forma. Se um
client secret nos app settings não for aceitável para você, o Pfx como blob é uma resposta melhor do
que uma chave de cofre protegida por software — uma chave em software é FIPS 140-2 Nível 1, o que
anula a maior parte do argumento a favor do cofre e mantém todo o seu custo. O restante desta seção
pressupõe que você escolheu o cofre; para Pfx, tudo o que você precisa está em
Certificados, mais o upload do blob abaixo.
Provisione o cofre, a chave e o registro de aplicativo
az keyvault create --name bulksigner-kv --resource-group bulksigner-rg --location brazilsouth --sku premium --enable-rbac-authorization true
Premium, porque a chave deve ser protegida por HSM. O Standard oferece uma chave em software, e o parágrafo acima explica por que esse é o lado errado desta troca.
Um certificado ICP-Brasil é entregue como PFX, então a chave é importada em vez de gerada. O
Import-PfxToKeyVault.ps1 faz toda a importação de uma só vez — grava o .cer público,
importa a parte privada como um objeto key, registra a aplicação no Entra, cria o segredo dela,
concede a ela sign e executa a mesma verificação de pareamento de chave pública que o serviço faz no
boot, de modo que uma divergência apareça aqui, e não no primeiro start:
pwsh Import-PfxToKeyVault.ps1 -PfxPath ./signer.pfx -VaultName bulksigner-kv -KeyName bulksigner-signing-key -AppDisplayName bulk-signer-prod -Destination HSM -GrantScope Key -SecretValidityYears 2
O Key Vault guarda este PFX de qualquer forma, mas um certificate importado de um PFX é marcado como
exportável: qualquer pessoa com secrets/get pode baixar o PFX completo do segredo associado a ele. Um
objeto key nunca devolve material privado, qualquer que seja a permissão. É por isso que a origem
deste produto usa somente a chave, e por isso o certificado público precisa ser fornecido separadamente.
O script imprime o client secret uma única vez e não o grava em lugar nenhum. Copie-o agora.
Coloque o certificado onde uma instância consiga lê-lo
O script deixa o .cer na sua estação de trabalho, o que não serve para um container cujo disco é
reciclado junto com ele. Faça o upload e permita que a identidade gerenciada o leia:
az storage blob upload --account-name contosocerts --container-name certificates --name signer.cer --file ./signer.cer --auth-mode login
Conceda a essa identidade Storage Blob Data Reader no container — a quarta das permissões que o passo
2 listou. O CerPath continua disponível e aponta para um arquivo local, mas nesta topologia isso
significa embutir o certificado na imagem, o que amarra a renovação anual do certificado a um novo build
da imagem e a uma implantação com parada total. Use o blob.
As configurações
São app settings como quaisquer outros, definidos aqui e não no passo 4 porque todos os valores foram produzidos pelos dois comandos acima:
az webapp config appsettings set --name bulksigner --resource-group bulksigner-rg --settings \
  Signing__Profiles__0__Certificate__Source=AzureKeyVault \
  Signing__Profiles__0__Certificate__AzureKeyVault__Endpoint='https://bulksigner-kv.vault.azure.net/' \
  Signing__Profiles__0__Certificate__AzureKeyVault__KeyName=bulksigner-signing-key \
  Signing__Profiles__0__Certificate__AzureKeyVault__AppId=99990000-aaaa-bbbb-cccc-ddddeeeeffff \
  Signing__Profiles__0__Certificate__AzureKeyVault__AppSecret='@Microsoft.KeyVault(VaultName=bulksigner-kv;SecretName=bulksigner-app-secret)' \
  Signing__Profiles__0__Certificate__AzureKeyVault__Blob__Url='https://contosocerts.blob.core.windows.net/certificates/signer.cer' \
  Signing__Profiles__0__Certificate__AzureKeyVault__Blob__Credential=ManagedIdentity \
  Signing__ProfileSecretsKey='@Microsoft.KeyVault(VaultName=bulksigner-kv;SecretName=bulksigner-profile-secrets-key)' \
  Pipeline__MaxConcurrency=4
O 0 é o índice do perfil em Signing:Profiles[] e é posicional — reordenar esse array faz estas
configurações apontarem silenciosamente para outro perfil. O Endpoint precisa ser uma URL https://
absoluta; um nome DNS puro é recusado no boot, com uma mensagem que cita a chave.
As configurações Signing__Profiles__0__* são um seed (carga inicial) de uso único. No primeiro
boot com uma tabela de perfis vazia, elas são importadas para o banco operacional como a linha do perfil;
depois disso, são ignoradas — o log de boot avisa isso toda vez que as encontra — e o perfil, incluindo o
certificado, passa a ser editado na página Perfis de assinatura do dashboard. Mantenha-as até o
primeiro boot ter rodado e então apague-as. Veja
Configuração.
O Signing__ProfileSecretsKey é a chave com a qual a importação criptografa o AppSecret, porque o
banco nunca guarda um segredo em texto claro, e a importação é recusada sem ela. Crie-a uma vez como
segredo do cofre — qualquer valor aleatório longo, openssl rand -base64 32, por exemplo —, lida pelo
mesmo tipo de referência do Key Vault, e saiba que perdê-la equivale a perder todos os segredos de perfil
armazenados: não há como recuperá-los. Veja
Configuração.
Com Pfx como blob, a senha do PFX também é um segredo desse tipo; só um PFX sem senha lido com
ManagedIdentity dispensaria a chave.
Blob e CerPath são mutuamente exclusivos — usar os dois é recusado no boot, e não usar nenhum tambémEssa recusa é deliberada, e não um excesso de rigor: dois certificados válidos para uma mesma chave de
cofre passariam na verificação de pareamento, então resolver o conflito por precedência faria com que
qual certificado assinou dependesse das condições da rede, sem possibilidade de auditoria. Note também
que o Blob não herda nada do bloco do cofre acima dele, embora ambos se refiram ao Azure — a credencial do
cofre concede uso de uma chave, a credencial do blob concede leitura de um objeto, e elas são
configuradas separadamente de propósito.
Um cofre, dois objetos, duas credenciais
O AppSecret acima é uma referência do Key Vault (Key Vault reference) do App Service — o único
ponto desta página em que o Key Vault aparece nos seus dois papéis ao mesmo tempo. Parece circular, mas
não é:
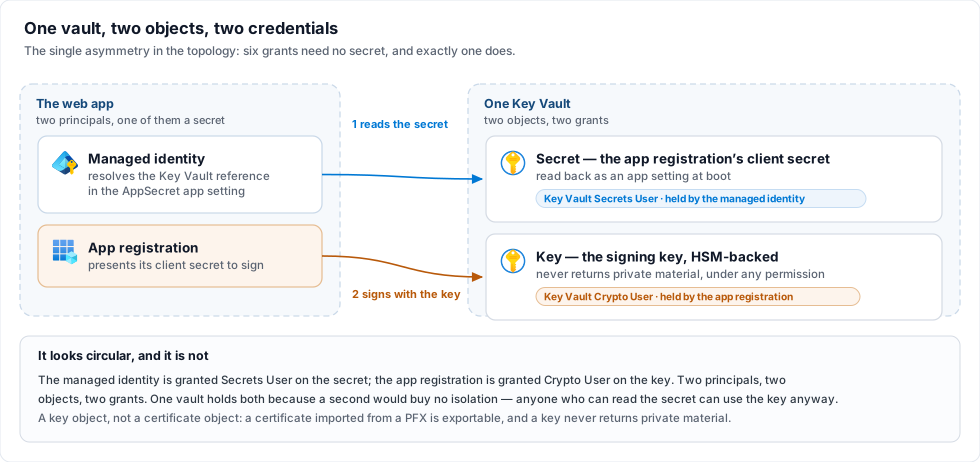
- A identidade gerenciada do web app resolve a referência e obtém o segredo — uma permissão
Key Vault Secrets User, sobre o segredo. - Esse segredo é, então, o que o conector do PKI apresenta para acessar a chave — uma permissão
Key Vault Crypto Userdo registro de aplicativo, sobre a chave, delimitada por-GrantScope Keyacima.
Duas entidades de segurança, dois objetos, duas permissões. O mesmo cofre guarda ambos porque um segundo cofre não traria isolamento algum — quem consegue ler o segredo consegue usar a chave de qualquer forma — e só acrescentaria mais um recurso. A observação do passo 4 de que segredos devem ficar em referências do Key Vault se refere a este mecanismo; a chave em si nunca é um app setting.
A latência é a restrição aqui, não o throttling
Certificados alerta que concorrência sustentada provoca respostas HTTP 429, que aparecem como jobs com falha, e não como travamentos. Vale saber disso, e vale conhecer a escala: o Key Vault permite 2.000 transações a cada 10 segundos para uma chave RSA-2048 em HSM — cerca de 200 assinaturas por segundo, para um produto que faz uma assinatura por job. A latência de ida e volta vai limitar você muito antes do teto.
O que é específico do cluster é a inversão do tema recorrente desta página. Em outros pontos desta
topologia, as cotas se multiplicam com as instâncias, a favor do atacante; aqui a cota é por cofre e
fixa, enquanto os consumidores se multiplicam. Pipeline__MaxConcurrency=4 é por instância, então duas
instâncias significam oito assinaturas em andamento contra um mesmo cofre. O AzureKeyVault é tratado
como seguro para concorrência e está isento do aviso de inicialização que se aplica a Pkcs11 e
WindowsStore.
Renovação e rotação são janelas de mudança
Três coisas aqui são lidas uma vez, no boot, e nada volta a consultá-las: os bytes do certificado no
blob, a chave do cofre indicada por KeyName e o client secret do registro de aplicativo. Mudar qualquer
uma delas exige, portanto, um restart — e um restart nesta topologia é a parada total do
passo 8, e não um rolling restart nem uma troca de slot. Planeje uma
renovação ICP-Brasil, e a expiração de -SecretValidityYears 2, como indisponibilidades agendadas, e
não como manutenção que pode ser feita a qualquer momento.
Depois do primeiro boot, o client secret fica no perfil armazenado, e não no app setting. O seed o
copiou, criptografado, para o banco operacional, e a referência do Key Vault em …__AppSecret não é
lida de novo. Para rotacioná-lo, portanto: crie o novo segredo no registro de aplicativo, informe-o na
página do perfil (Editar certificado, digitando o novo valor — um campo em branco mantém o armazenado)
e reinicie. É no mesmo formulário que se indica um .cer renovado ou um novo KeyName; ao salvar, o
perfil fica marcado como aguardando reinicialização, e a mudança entra em vigor no restart.
Um certificado novo com o KeyName antigo, ou uma chave nova com o .cer antigo, reprova na
verificação de pareamento. O host sobe mesmo assim, mas aquele perfil fica degradado e todo job
roteado para ele falha com profile.degraded — em uma implantação com um único perfil, a janela de
mudança termina sem nada sendo assinado. Execute novamente o script de importação com o novo PFX, para
que os dois artefatos sejam atualizados juntos, e confira a linha profile no
passo 6 antes de considerar a janela encerrada.
O que este passo pressupõe sobre a rede
Todos os comandos acima acessam o respectivo serviço por um endpoint público com uma credencial, e o mesmo vale para o SQL, o Azure Files e o blob do certificado nesta página. Restringir qualquer um deles exige integração com VNet e private endpoints, que é o passo 9, opcional.
4. App settings
Os app settings do App Service são por app, não por instância — e é nesse fato que toda a
arquitetura se apoia: todas as instâncias são idênticas por construção, então os riscos de divergência
de configuração entre instâncias (uma senha de criptografia diferente entre hosts, um perfil que uma
instância desconhece) não existem aqui. Defina-os como variáveis de ambiente, na forma com duplo
sublinhado; não há um appsettings.Production.json para montar.
az webapp config appsettings set --name bulksigner --resource-group bulksigner-rg --settings \
  WEBSITES_PORT=8080 \
  Cluster__Enabled=true \
  Database__Provider=SqlServer \
  ConnectionStrings__Default='Server=tcp:sqlsrv01.database.windows.net,1433;Initial Catalog=BulkSigner;Authentication=Active Directory Managed Identity;Encrypt=True;' \
  Storage__Provider=AzureFiles \
  Storage__AzureFiles__AccountName=contosofiles \
  Storage__AzureFiles__ShareName=bulksigner \
  Storage__AzureFiles__Directory=prod \
  Storage__AzureFiles__Credential=ManagedIdentity \
  Storage__Inputs__0__Name=remessas \
  Storage__Inputs__0__Path=entrada/remessas \
  Storage__Inputs__0__PollIntervalSeconds=30 \
  Hosting__ForwardedHeaders__Enabled=true \
  Hosting__ForwardedHeaders__TrustAnyProxy=true \
  Logging__AzureTable__Enabled=true \
  Telemetry__Enabled=true
Esse bloco é a topologia, não a configuração inteira. Ele omite de propósito tudo o que é igual
aqui e em qualquer outro alvo — a licença do PKI, a chave de API, os perfis de assinatura, os pools de
aprovadores. A única exceção é o certificado de um perfil, que definitivamente não é igual aqui e
nos outros alvos, e foi definido no passo 3, logo acima.
Copie o restante do arquivo appsettings.Example.Azure.json.sample do pacote de implantação, que traz
um exemplo completo, preenchido de ponta a ponta, e converta cada chave para a forma com duplo
sublinhado (Signing:Profiles[0].Certificate.Source →
Signing__Profiles__0__Certificate__Source). Toda configuração Signing__Profiles__* e
Storage__Inputs__*__Profile é entrada do seed, lida somente no primeiro boot; depois que os
perfis estão no banco, eles — incluindo pool, quórum, pasta de entrada e certificado — são editados pelo
dashboard, de forma idêntica para todas as instâncias. Um perfil cujo certificado não pode ser resolvido
não interrompe o boot: ele sobe degradado, identificado no banner e no /api/ready, e todos os
outros perfis continuam assinando.
Segredos — Signing__PkiSdkLicense, Auth__ApiKey, Signing__ProfileSecretsKey,
ApproverPortal__LinkSecret, CloudHub__ApiKey, qualquer AppSecret — devem ficar em referências do
Key Vault, e não em app settings literais, resolvidas pela identidade gerenciada do web app, que tem a
permissão Key Vault Secrets User. O passo 3 usa exatamente esse mecanismo para o próprio client secret
do cofre, e explica ali por que isso não é circular. Todas as chaves que este produto aceita, com tipo,
padrão e forma de variável de ambiente, estão em
Configuração.
Cinco das configurações acima são específicas do cluster, e vale conhecer o motivo de cada uma:
Cluster__Enabled=trueé o único interruptor. Nada é inferido do ambiente: uma implantação que por acaso rode SQL Server e um compartilhamento do Azure Files não muda de comportamento silenciosamente numa atualização.Cluster__HeartbeatSeconds/Cluster__StaleAfterSecondsestão ausentes acima porque os padrões (15 e 60) são o ponto de partida correto — quatro cadências, de modo que três heartbeats precisam faltar antes de uma instância ser presumida morta. Um limiar abaixo de três cadências é recusado no boot, com uma mensagem que cita as duas chaves. AumenteStaleAfterSecondsse ocorrerem falsas mortes; veja por que uma morte presumida é uma suposição.Hosting__ForwardedHeaders__*é o que faz o limitador de requisições e o endereço registrado em uma aprovação enxergarem o cliente real, e não o balanceador de carga.TrustAnyProxy=trueé a configuração pretendida aqui — o front end do App Service não tem endereço estável para listar — e somente aqui: em uma implantação com proxy reverso, isso significa que qualquer pessoa que alcance o Kestrel diretamente pode se apresentar com qualquer endereço de cliente. Um conjunto de confiança vazio é recusado no boot, em vez de ser interpretado como a opção mais ampla, e definir também oASPNETCORE_FORWARDEDHEADERS_ENABLEDdo próprio framework é recusado.WEBSITES_PORT=8080corresponde aoEXPOSEda imagem. O App Service detecta automaticamente as portas 80 e 8080, então isto é uma precaução redundante — e uma configuração custa menos que o diagnóstico quando uma imagem futura mudar de porta.- Não defina
Hosting__RequireHttps. Faça a terminação TLS na plataforma com ohttpsOnlyabaixo. Um redirecionamento no próprio processo responde ao ping do health check com um 307, que o App Service interpreta como falha — veja a nota sobre o health check abaixo.
O App Service não define nome de ambiente, então o app roda como Production — ambiente no qual o
Signing:TrustLacunaTestRoot
é recusado no boot. Um app de homologação que queira os certificados de teste Turing / Fermat define
Signing__TrustLacunaTestRoot=true e ASPNETCORE_ENVIRONMENT=Staging no mesmo comando. Nunca defina
o primeiro em um app que assine algo real.
5. Configurações de plataforma
az webapp update --name bulksigner --resource-group bulksigner-rg --set clientAffinityEnabled=true httpsOnly=true
az webapp config set --name bulksigner --resource-group bulksigner-rg --always-on true --generic-configurations '{"healthCheckPath": "/api/ready"}'
A afinidade ARR continua ligada. Ela vem ligada por padrão e é um requisito, não uma preferência: o dashboard é Blazor Server, e o circuito dele é uma conexão SignalR com estado que precisa continuar chegando à instância que o mantém. Esse comportamento é documentado, e não contornado com engenharia. Note o que ela não faz — o cookie de sessão em si é compartilhado, porque no modo cluster o key ring de Data Protection passa para o banco operacional, de modo que um cookie emitido por uma instância é validado por todas as outras. As sticky sessions servem ao circuito; o key ring, ao cookie. Sem o key ring, só a afinidade ainda desconectaria as pessoas de forma intermitente.
O Always On continua ligado. O pipeline de assinatura é um worker hospedado, não um manipulador de requisições. Um app que a plataforma descarrega quando ocioso para de pegar arquivos, e nada disso aparece como erro em lugar algum.
O health check lê o endpoint de readiness
O /api/ready é anônimo, por instância, e retorna 503 quando qualquer um dos seus probes falha —
exatamente a pergunta que o App Service está fazendo. Aponte o Health check para ele e a plataforma deixa
de rotear para uma instância que não consegue atender, e por fim substitui a que continuar assim.
Ele é anônimo por causa desse consumidor: o Health check não consegue enviar a chave de API (a
Microsoft documenta que o caminho precisa permitir acesso anônimo quando o app tem autenticação
própria), então o Readiness:RequireApiKey fica no padrão false aqui. Ligá-lo faria a plataforma
interpretar o 401 de todas as instâncias como "não saudável" ao mesmo tempo — nenhuma é removida da
rotação, a plataforma começa a substituí-las, uma por hora, e a métrica do Health check fica vermelha
enquanto a exigência estiver ligada. O corpo anônimo traz apenas o nome e o veredito de cada
verificação; o diagnóstico — servidor e catálogo, URLs de compartilhamentos, a mensagem de falha de um
SDK — fica no /api/ready/details, protegido pela chave de API.
Três consequências a aceitar conscientemente:
- Deixe
WEBSITE_HEALTHCHECK_MAXPINGFAILURESno padrão (10). O endpoint é rigoroso — uma única pasta de entrada ausente reprova a resposta inteira — então um limiar apertado transforma uma oscilação em uma remoção. - A falha de uma dependência compartilhada derruba todas as instâncias juntas. Um compartilhamento que para de responder ou um banco que estava inalcançável no boot não é problema de uma só instância, e a regra da plataforma é que, quando todas as instâncias estão não saudáveis, nenhuma é removida do balanceador de carga — mas a substituição continua acontecendo, no máximo uma por hora e três por dia por plano. O app continua alcançável; as instâncias vão sendo recicladas enquanto a falha real está em outro lugar. Leia Diagnóstico de problemas antes de concluir que a culpa é da plataforma.
- O Health check não segue redirecionamentos. É por isso que
Hosting:RequireHttpsfica desligado: com ele ligado e ohttpsOnlyda plataforma desligado, o ping recebe um 307 e a instância é marcada como não saudável por um motivo que nada tem a ver com sua saúde.
6. Primeiro boot, em uma instância
Inicie o app e acompanhe o console — é no streaming de logs do App Service que aparecem as mensagens do boot:
az webapp log tail --name bulksigner --resource-group bulksigner-rg
O que procurar no painel Service ready:
| Linha | O que ela deve dizer |
|---|---|
operational store | SQL Server (sqlsrv01/BulkSigner) — o provider, o servidor e o catálogo, nunca a connection string. Um aviso READ_COMMITTED_SNAPSHOT is off merece atenção: no Azure SQL, essa opção vem ligada por padrão. |
storage provider | AzureFiles |
work share owner | this cluster (one marker, shared between instances) — o texto que confirma que o modo está de fato ligado. Com o modo desligado, esta linha mostra o nome de uma instância. |
azure shares | alcançáveis. Um compartilhamento inalcançável não impede o host de subir, mas reprova o /api/ready, e nada é ingerido dele até que volte a responder. |
forwarded headers | o conjunto de confiança, por nome, e não apenas on. |
logs | o destino em tabela entre os destinos listados. Se ele estiver ausente, você também terá visto o Critical sobre arquivos de log rotacionados em disco efêmero. |
profile | o certificado que de fato foi carregado — cades · cert=AzureKeyVault · blob=contosocerts/certificates/signer.cer · verify=on · …. As duas partes são evidências: cert=AzureKeyVault significa que o cofre respondeu e a chave foi encontrada, blob=… significa que o .cer foi lido e pareado com ela. Uma linha com o prefixo DEGRADED · significa que o certificado não foi resolvido, com o motivo ao lado. Esta é a linha a conferir após qualquer renovação de certificado — é a única confirmação de que os dois artefatos foram atualizados juntos. |
Depois, faça um GET /api/ready/details com a chave de API e confirme que todas as verificações estão
verdes, abra Perfis de assinatura para confirmar que o seed importou o que você pretendia e abra
Sistema → Instâncias no dashboard: uma linha, marcada como a instância em que você está navegando,
com um chip Viva.
Suba uma vez com Cluster:Enabled = false e deixe a recuperação rodar antes de ligar o modo. Uma
linha deixada em andamento por um build mais antigo não tem dono, e no modo cluster nada jamais vai
recuperá-la — cada boot trata apenas da sua própria encarnação anterior, os jobs de uma instância irmã
ficam com ela, e a assunção depende do heartbeat de um dono, que aqui não existe. O mesmo vale para um
job enviado ao Lacuna Signer por um build assim. As duas interfaces avisam quando encontram um caso
desses e indicam esta mesma solução. É uma preocupação única, no momento da atualização: o dono é
registrado em toda reivindicação, com o modo ligado ou não, e só é lido com o modo ligado.
7. Escale para duas
az appservice plan update --name bulksigner-plan --resource-group bulksigner-rg --number-of-workers 2
Aguarde um minuto — o App Service consulta o caminho do health check para confirmar que a nova instância está pronta antes de rotear para ela — e recarregue Sistema → Instâncias.
O resultado esperado: duas linhas, cada uma com uma identidade derivada distinta (o
WEBSITE_INSTANCE_ID da plataforma, que o App Service define em toda instância), cada uma Viva,
ambas na mesma versão da aplicação, uma delas marcada como a instância que respondeu à sua requisição.
A legenda mostra a cadência e o limiar de inatividade em vigor. Atualize algumas vezes: a marcação muda
de linha, porque cada recarga pode cair em qualquer uma das instâncias — é o balanceador de carga
fazendo o seu trabalho, e a primeira coisa nesta página que você pode ver, em vez de deduzir.
Depois, confirme que o cluster de fato coopera
A visão Instâncias prova que ambas as instâncias estão vivas. Ela não prova que elas dividem o trabalho.
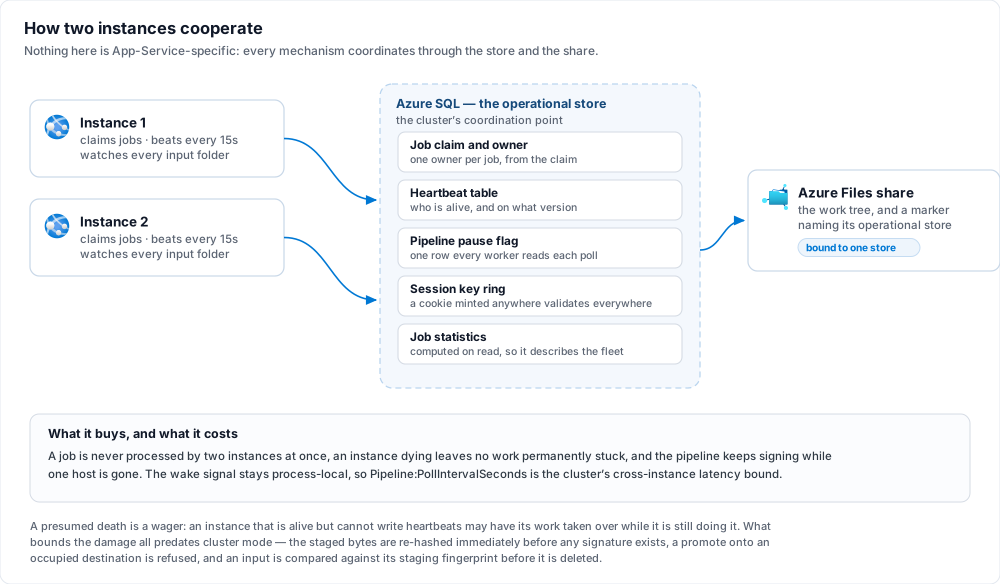
Coloque vários arquivos de uma vez em uma pasta monitorada e confira /jobs:
- Cada arquivo vira exatamente um job. As duas instâncias monitoram todas as pastas, então disputam
cada arquivo que chega; o enfileiramento perdedor é recusado pelo índice único parcial sobre os
caminhos originais ativos e respondido como
AlreadyActive, e um conflito de lease em uma entrada é classificado como esperado — não conta para o disjuntor de falhas consecutivas da pasta nem é registrado como erro. Aqui, contenção é sinal de que o sistema funciona, e não uma falha. - Os jobs pertencem às duas instâncias. O
/api/folderstraz um campoinstanceque indica qual delas respondeu; a linha do tempo do job em/jobs/{id}mostra o restante. - Pare uma instância (volte a escala para uma) e o trabalho em andamento dela é reconciliado pela
sobrevivente, em vez de ficar órfão: um job que nunca chegou à chamada de assinatura volta para a
fila, um que já passou dela falha por precaução, e um job
AwaitingSigneré reatribuído. Cada assunção grava um evento operacionalJobTakenOvercom o nome das duas instâncias. A política completa, inclusive por que "falhou" é um desfecho honesto, e não "travado", está em Operação.
8. Atualizações exigem parada total
Pare o app, implante a nova imagem e inicie-o — com um passo antes desses três, porque a imagem vem do registry da Lacuna, e não de um build:
az acr import --name <nome-do-registry> \
  --source <registry-da-lacuna>/bulksigner:<nova-versão> \
  --image bulksigner:<nova-versão> \
  --username <usuário-do-registry> --password <token-do-registry>

az webapp stop --name bulksigner --resource-group bulksigner-rg
az webapp config container set --name bulksigner --resource-group bulksigner-rg \
  --container-image-name <nome-do-registry>.azurecr.io/bulksigner:<nova-versão>
az webapp start --name bulksigner --resource-group bulksigner-rg
Não é um rolling restart, e não é uma troca de deployment slot — um slot de staging com a connection string de produção é um segundo conjunto de instâncias entrando no cluster em outra versão da aplicação, justamente o único cenário que esta arquitetura não suporta.
O stop torna a implantação mais limpa, mas não é obrigatório. Mudar a imagem de um app em execução
inicia o container novo ao lado do antigo, na mesma instância; ambos derivam a mesma identidade do
WEBSITE_INSTANCE_ID, e a plataforma mantém o antigo rodando até o novo estar aquecido. Desde a 2.5.0, o
container novo desloca o antigo imediatamente e o antigo se retira — não pega nada novo e termina
o que já tem —, então um container set in-place funciona, ao custo de um aviso com o nome da encarnação
deslocada; se a plataforma derrubar o container antigo antes, os jobs inacabados dele são assumidos
Cluster:StaleAfterSeconds depois. Parando primeiro, nada se sobrepõe: o container antigo encerra sua
linha de heartbeat ao desligar, e o novo não tem nada a deslocar. (Até a 2.4.x, uma troca in-place
custava pelo menos um início recusado.)
Duas coisas a saber sobre uma troca in-place:
- Se o container novo falhar no aquecimento, volte para a tag anterior. O App Service para o site
inteiro — inclusive o container que se retirou — e continua tentando reiniciá-lo com a imagem nova; o
container antigo não tem como retomar o trabalho. A recuperação é
az webapp config container set … --container-image-name <nome-do-registry>.azurecr.io/bulksigner:<versão-anterior>. - Alguns segundos depois de a plataforma remover o container antigo, o primeiro comando ao banco em
cada conexão que o novo abriu durante o aquecimento pode falhar uma vez com um
Execution Timeout Expiredde 35 segundos. É uma conexão cortada junto com o container antigo, e não um problema no banco: uma falha por conexão desse tipo, e depois o pool se recupera sozinho. Uma implantação que para o app primeiro não tem esse efeito.
A marca de versão no heartbeat funciona como alarme, e não como uma verificação que bloqueia: uma instância que, ao subir, encontra heartbeats ativos de outra versão registra um Critical e continua. De propósito, isso não é uma recusa — recusar impediria as instâncias de subir por todo o tempo que um heartbeat morto da versão antiga levasse para expirar, que é exatamente quando um operador precisa delas no ar.
O argumento completo, e o resto do que esta topologia não oferece, está em Alta disponibilidade e seus limites.
9. Reforce a segurança da rede (opcional)
Tudo acima resulta em um cluster funcional, acessado por endpoints públicos com credenciais. Esta seção é o que você acrescenta depois que ele funciona, e ela é realmente opcional — mas um dos itens não é defesa genérica, e sim uma limitação documentada desta topologia que se transforma em problema resolvido.
As cotas param de se multiplicar. Alta disponibilidade lista isso como um custo da escala horizontal: cada instância impõe a sua própria cota por cliente, então duas instâncias dão a um atacante o dobro da cota na rota de aprovação, e N instâncias, N vezes. Um limite de requisições no WAF do Front Door fica antes do balanceador de carga, o que o torna o único ponto desta arquitetura em que uma cota por cliente é aplicada uma única vez, e não por instância. Nada mais nesta página resolve isso.
O motivo para não fazer: esta seção acrescenta quatro recursos cobrados e a mudança para uma camada superior, além de um plano e de um cofre que já são Premium. Não há valores aqui — os preços do Azure ficam desatualizados mais rápido que qualquer documento.
Para a entrada, há dois modelos, e só um deles pode valer por vez. Ou o app permanece na internet atrás de um Front Door — o resto deste passo — ou ele sai completamente da internet e passa a ser acessado por VPN, que é o passo 10 e traz consequências que vão além da rede. A parte de saída, abaixo, é o mesmo trabalho nos dois casos. Leia os dois antes de implementar qualquer um — o segundo é a resposta mais forte para a rota de aprovação anônima e a mais fraca para tudo o que um WAF faz, e qual desses aspectos importa mais é uma pergunta que esta página não pode responder por você.
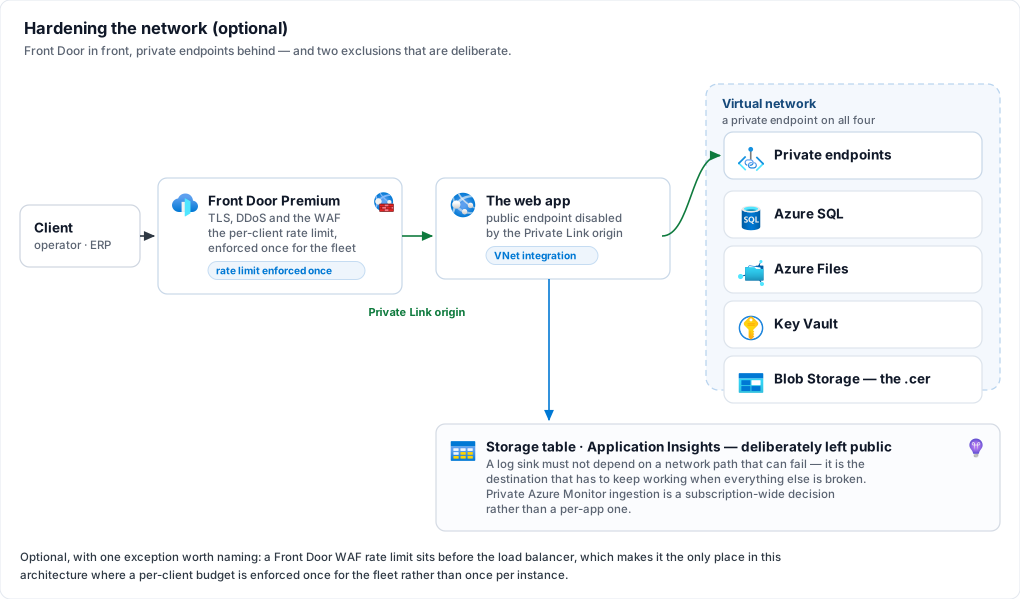
Entrada — Front Door na frente do app
O Front Door Premium com uma origem via Private Link é a recomendação, porque o App Service desabilita automaticamente seu endpoint público de internet quando a origem é alcançada por Private Link — o que, neste produto, traz um benefício específico, descrito dois parágrafos abaixo.
A alternativa mais barata é o Front Door Standard mais uma restrição de acesso do App Service:
az webapp config access-restriction add --name bulksigner --resource-group bulksigner-rg --rule-name frontdoor --priority 100 --service-tag AzureFrontDoor.Backend --http-header x-azure-fdid=<id-do-front-door>
As duas partes dessa regra são obrigatórias, e é o header que faz a diferença. A Microsoft deixa
explícito que a filtragem por IP sozinha não basta, porque as instâncias de Front Door de outros
clientes do Azure usam as mesmas faixas de endereço — a service tag AzureFrontDoor.Backend prova que o
tráfego veio por um Front Door, e só o X-Azure-FDID prova que veio pelo seu. Nunca liste as faixas
de endereço manualmente em vez de usar a tag; esses endereços mudam com frequência.
É isto que finalmente torna o TrustAnyProxy=true do passo 4 verdadeiro, e não apenas pretendido.
Lá, essa configuração é justificada pelo fato de o front end do App Service não ter endereço estável
para listar, com o aviso de que, numa implantação com proxy reverso, ela permite que qualquer pessoa que
alcance o Kestrel diretamente se apresente com qualquer endereço de cliente. Neste produto, esse
endereço não é cosmético: ele é registrado em cada aprovação como um dos controles compensatórios da
rota de aprovação anônima, e é por ele que o limitador de requisições faz a contagem. Um Front Door
sem bloqueio de origem ampliaria esse risco e ainda passaria a impressão de proteção. Com o Private
Link, o risco desaparece por completo, porque não sobra endpoint público para acessar; com a regra do
Standard, ele só desaparece na medida em que aquela restrição de acesso se sustentar — uma garantia mais
fraca, que deve ser tratada como tal.
Mantenha TrustAnyProxy=true nas duas camadas. Não migre para
Hosting__ForwardedHeaders__KnownNetworks — ele recebe CIDRs literais, as faixas do Front Door mudam, e
uma lista desatualizada falha descartando silenciosamente o endereço real do cliente, em vez de recusar
alguma coisa. O produto recusa TrustAnyProxy junto com uma lista explícita, então é realmente uma coisa
ou outra, e a resposta correta aqui é a confiança ampla com a origem bloqueada.
Três interações de configuração a acertar:
- Deixe ligada a afinidade de sessão do próprio Front Door. O dashboard é um circuito Blazor Server e precisa de fixação de ponta a ponta; a afinidade do Front Door é o que mantém um cliente na origem cujo cookie ARR ele carrega. As duas camadas cooperam — o Front Door escolhe a origem, o ARR escolhe a instância.
- Não aponte o health probe do Front Door para
/api/ready. Há exatamente uma origem aqui, então uma falha do probe não tem para onde fazer failover e simplesmente tira a aplicação inteira do ar. O próprio Health check do App Service já monitora esse endpoint e pode agir com base nele, redirecionando entre instâncias. Dê ao Front Door um caminho leve ou deixe o probe dele no padrão. - O domínio personalizado e o TLS gerenciado passam para o Front Door. O
httpsOnly=truedo App Service fica exatamente como o passo 5 o deixou, e oHosting:RequireHttpscontinua sem ser definido, pelo motivo que o passo 5 explica.
Aqui, o Front Door é um WAF, um terminador de TLS e uma camada de proteção contra DDoS, e não um balanceador de carga global para esta aplicação. Uma segunda região seria um segundo conjunto de instâncias sobre o mesmo compartilhamento de trabalho, e a verificação do marcador do compartilhamento recusa isso por design — veja Alta disponibilidade.
Saída — integração com VNet e private endpoints
Integre o web app a uma sub-rede e crie um private endpoint para cada um dos quatro serviços de plano de dados: o Azure SQL, o compartilhamento do Azure Files, o cofre e o blob do certificado. Os quatro, e não três — com private endpoint na maioria deles, o que sobrar anula a razão de ser da rede virtual, e ninguém percebe até que uma auditoria perceba.
Duas exclusões, ambas deliberadas:
- A tabela de logs continua pública. Ela é o destino que precisa continuar funcionando quando todo o resto falhou; um destino de log não pode depender justamente de um caminho de rede que pode falhar, já que um destino incapaz de relatar a própria falha é uma indisponibilidade que se esconde.
- O Application Insights continua público. A ingestão privada exige um Azure Monitor Private Link Scope, um recurso à parte, com consequências próprias de DNS para todos os recursos que o compartilham — uma decisão maior que esta seção, que deve ser tomada para uma assinatura do Azure inteira, e não para um único web app.
10. Nenhum endpoint público (opcional)
As duas opções de entrada são mutuamente exclusivas, e esta é a segunda: se você implementou o Front Door do passo 9, não implemente esta. Em vez de colocar um Front Door na frente de um app público, crie um private endpoint para o app e depois remova o endpoint público dele, de modo que a única rota até ele parta da sua própria rede: uma VPN site a site ou ponto a site, ou o peering privado do ExpressRoute. A Saída é comum aos dois modelos e se aplica aqui sem mudança — o que este passo substitui é a parte de entrada que o diagrama do passo 9 descreve. O argumento da cota, na abertura do passo 9, vale só para o Front Door; este modelo trata a questão de outra maneira, e não a ignora — O que este modelo não resolve, abaixo, explica como.
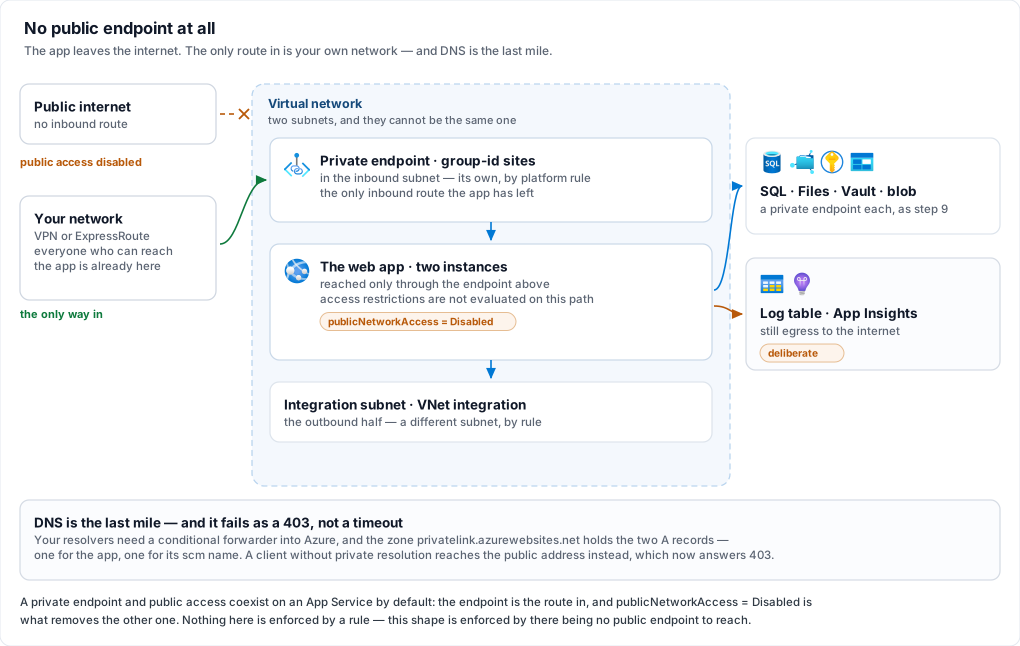
Escolha este modelo quando o requisito for que ninguém fora da sua rede alcance este serviço de forma alguma, e o Front Door quando o serviço precisar ser acessível pela internet e a única questão for com que nível de segurança.
A rota de aprovação anônima deixa de ser acessível pela internet, e esse é o ganho mais importante
desta página. O /approve/{jobId} e o POST /api/approvals/{id} não exigem credencial, por design —
uma decisão compensada, e não escondida, com um método de identificação registrado, o endereço e o user
agent do aprovador, uma cota própria e recusas deliberadamente genéricas (Aprovações).
Cada um desses controles foi projetado para uma página que qualquer pessoa poderia carregar. Remova o
endpoint público e quem consegue alcançar a rota passa a ser apenas quem já tem acesso à sua rede, uma
compensação mais forte do que qualquer coisa que o próprio produto possa oferecer. Se essa rota sem
autenticação é o motivo de você estar lendo esta seção, a resposta é este modelo, e não o Front Door.
Pelo outro lado, esse também é o custo: um aprovador que não está na rede não consegue aprovar. O link do portal é um HMAC derivado que funciona em qualquer dispositivo, e este modelo transforma o acesso à rede na restrição determinante. Levante quem são os aprovadores antes de decidir — um diretor aprovando uma folha de pagamento pelo celular, um auditor externo, qualquer pessoa em um cliente —, porque, para cada um deles, a solução passa a ser um cliente de VPN naquele dispositivo, e é muito melhor saber disso agora do que depois que a primeira folha ficar retida num fim de semana.
O que este modelo não resolve. Não há WAF aqui, então a cota ×N continua ×N; o que muda é quem pode
consumi-la, não a aritmética. O /api/metrics continua caindo em uma instância arbitrária, e as
atualizações continuam exigindo parada total. Se você precisa de um WAF e de nenhuma exposição
pública, a resposta é um Application Gateway interno em vez do Front Door — que sempre tem um front end
público próprio —, e isso é um terceiro modelo de implantação, não documentado aqui.
Mantenha Hosting__ForwardedHeaders__* exatamente como o passo 4 o deixou, e o
endereço registrado fica mais preciso. O Private Link encaminha o endereço real do cliente para o app,
então o que aparece em um registro de aprovação é o endereço do próprio aprovador, e não o de um salto
de proxy. O TrustAnyProxy=true também deixa de ter a ressalva que o passo 4 faz a ele, pelo mesmo
motivo da opção de origem via Private Link: com o acesso público desabilitado, não sobra, fora da rede,
nenhum caminho até o Kestrel que possa ser explorado.
Provisione o private endpoint
O private endpoint precisa de uma sub-rede própria — não a que a integração com VNet usa. Isso é uma restrição da plataforma, e não uma preferência, e é o motivo mais comum para esta etapa ter de ser refeita:
az network private-endpoint create --resource-group bulksigner-rg --name bulksigner-pe --vnet-name bulksigner-vnet --subnet inbound --group-id sites --connection-name bulksigner-sites --private-connection-resource-id $(az webapp show --name bulksigner --resource-group bulksigner-rg --query id -o tsv)
az network private-dns zone create --resource-group bulksigner-rg --name privatelink.azurewebsites.net
az network private-dns link vnet create --resource-group bulksigner-rg --zone-name privatelink.azurewebsites.net --name bulksigner-vnet-link --virtual-network bulksigner-vnet --registration-enabled false
az network private-endpoint dns-zone-group create --resource-group bulksigner-rg --endpoint-name bulksigner-pe --name default --private-dns-zone privatelink.azurewebsites.net --zone-name azurewebsites
az resource update --ids $(az webapp show --name bulksigner --resource-group bulksigner-rg --query id -o tsv) --set properties.publicNetworkAccess=Disabled
Esse último comando é o que realmente resolve, e criar o private endpoint não o torna desnecessário.
Por padrão, um private endpoint e o acesso público coexistem em um App Service: crie o endpoint,
conecte-se pela VPN, veja funcionar — e o app continua na internet exatamente como antes. Note também
que as regras de restrição de acesso do app não são avaliadas para o tráfego que chega pelo private
endpoint, então a regra x-azure-fdid da opção do Front Door não tem efeito aqui. Este modelo é
garantido pela inexistência de um endpoint público, nunca por uma regra.
403, não como um timeoutO nome público do app continua sendo resolvido depois que o endpoint existe — para um endereço público
que agora recusa o acesso. Um cliente sem resolução privada configurada recebe, portanto, um 403 da
plataforma, que parece um problema de permissão, mas não é. São necessários dois registros A em
privatelink.azurewebsites.net, um para o app e outro para o nome scm dele; o grupo de zona DNS acima
cria os dois, e é por isso que vale usá-lo em vez de criar os registros manualmente. Clientes de VPN
resolvem nomes pelo seu próprio DNS, então a última etapa é um encaminhador condicional dos seus
resolvedores para o Azure — um endpoint de entrada do
Azure DNS Private Resolver é a
forma gerenciada de fazer isso. Continue usando o nome de host padrão *.azurewebsites.net: o
certificado da plataforma é emitido para ele, e um domínio personalizado aqui exige trazer o seu próprio
certificado.
Duas coisas que você fez em passos anteriores passam a depender da rede interna. O
passo 6 lê as mensagens do boot com az webapp log tail, que acessa
o site SCM do app — agora privado; portanto, execute o comando em uma estação conectada à VPN, ou leia o
boot no destino de log em tabela. E, se você também criar um private endpoint para o container registry,
o pull da imagem precisa ser roteado explicitamente pela rede, definindo properties.vnetImagePullEnabled
do mesmo jeito que o passo 2 define acrUseManagedIdentityCreds; um registry que continua público não
precisa de nada. O que não muda é tudo o que a plataforma faz internamente — o
Health check continua consultando /api/ready e a
afinidade ARR continua fixando o circuito Blazor, ambos internos ao App Service e indiferentes a tudo
isso.
O app mantém o caminho de saída para a internet, e as duas exclusões deliberadas em Saída, acima, dependem dele: o destino de log em tabela do Azure e o Application Insights. Se o seu requisito também abrange a saída, toda a discussão gira em torno desses dois — o Application Insights precisa de um Azure Monitor Private Link Scope, e a tabela de logs precisa de um private endpoint na conta de armazenamento dela, o que contradiz o motivo pelo qual aquela exclusão existe: um destino de log é o único destino que precisa continuar funcionando quando o que falhou foi a rede. Leia esse argumento antes de fechar esse caminho, e note que simplesmente desligar o destino não é a saída fácil — no modo cluster, isso registra um Critical na inicialização, porque os arquivos de log rotacionados de um container somem junto com ele (Antes de começar, item 5).
Quando algo é recusado
Todos os modos de falha do cluster, com a mensagem exata e a correção de cada um, estão em Diagnóstico de problemas. Os mais prováveis em uma primeira implantação:
| Sintoma | Causa |
|---|---|
Cluster mode refused to start, citando chaves | Uma das recusas de boot em Antes de começar. A mensagem lista todas as chaves com problema de uma só vez, em vez de uma por tentativa. |
| O container nunca inicia | Ou o pull da imagem falhou (acrUseManagedIdentityCreds nunca definido — passo 2), ou houve uma recusa de boot. O fluxo de log distingue os dois casos — uma falha de pull o deixa vazio, porque ainda não há aplicação, enquanto uma recusa cita a chave antes de encerrar. A importação do primeiro boot é recusada, por exemplo, quando um perfil tem um segredo e o Signing__ProfileSecretsKey não está definido (passo 3). Leia o fluxo antes de supor que o problema é o registry. |
O app sobe mas o perfil está DEGRADED e todo job falha com profile.degraded | O perfil não conseguiu resolver seu certificado: um cofre inalcançável, um client secret expirado ou um .cer que não pareia com o KeyName (passo 3). O motivo está na linha profile do banner e no /api/ready/details. Corrija na página do perfil (Editar certificado) ou no cofre, e então reinicie. |
O boot avisa displaced the previous incarnation … which was still live | Uma reimplantação in-place (passo 8): o container novo assumiu a identidade e o antigo se retirou — o esperado em toda troca in-place. Se este host não está no meio de uma reimplantação, dois hosts estão usando a mesma identidade e vão se revezar: leia os dois logs e renomeie um deles, ou aponte-o para um banco de dados próprio. |
Boot recusado dizendo que a identidade could not be registered in 3 attempts | Todas as gravações da linha de heartbeat perderam a disputa para outra encarnação: dois hosts com o mesmo nome subindo no mesmo instante contra o mesmo banco de dados, ou uma falha no banco. Encontre o outro host na visão Instâncias de uma instância que esteja rodando. |
| Boot recusado citando dois bancos operacionais | O marcador do compartilhamento de trabalho indica que ele pertence a outro banco operacional. Dois clusters sobre o mesmo compartilhamento de trabalho destroem os dados um do outro sem que banco de dados algum perceba, e é isso que essa verificação existe para detectar. |
| Operadores mandados de volta ao login de forma intermitente | As instâncias não estão compartilhando o mesmo key ring — geralmente um host com Cluster:Enabled falso, ou instâncias apontadas para bancos diferentes. |
Relacionados: Alta disponibilidade e seus limites · Instalação · Certificados · Configuração · Operação · Diagnóstico de problemas